
把会议转写放到 RK3588 上,除了让模型跑起来,还要决定有限的计算花在哪:先选哪一路麦克风,什么时候值得追加另一套识别器?这篇记录的是麦克风选择与识别器级联的研究,公开仓库保留了数值复算材料和历史实现。
比较策略时分别记录识别质量与运行时间,并区分麦克风输入变化和识别器变化带来的影响。
1. 麦克风选择与识别器级联
1.1 麦克风输入选择
同一句话使用不同麦克风输入,识别结果可能不同。输入选择比较的就是这部分差异。
1.2 识别器级联策略
级联先走一条识别路径,再按策略决定是否追加另一种处理。把输入选择和级联放进同一系统以后,置信度、选择策略和成本记录都要固定版本,不然两组结果可能连输入和预算都不一样。
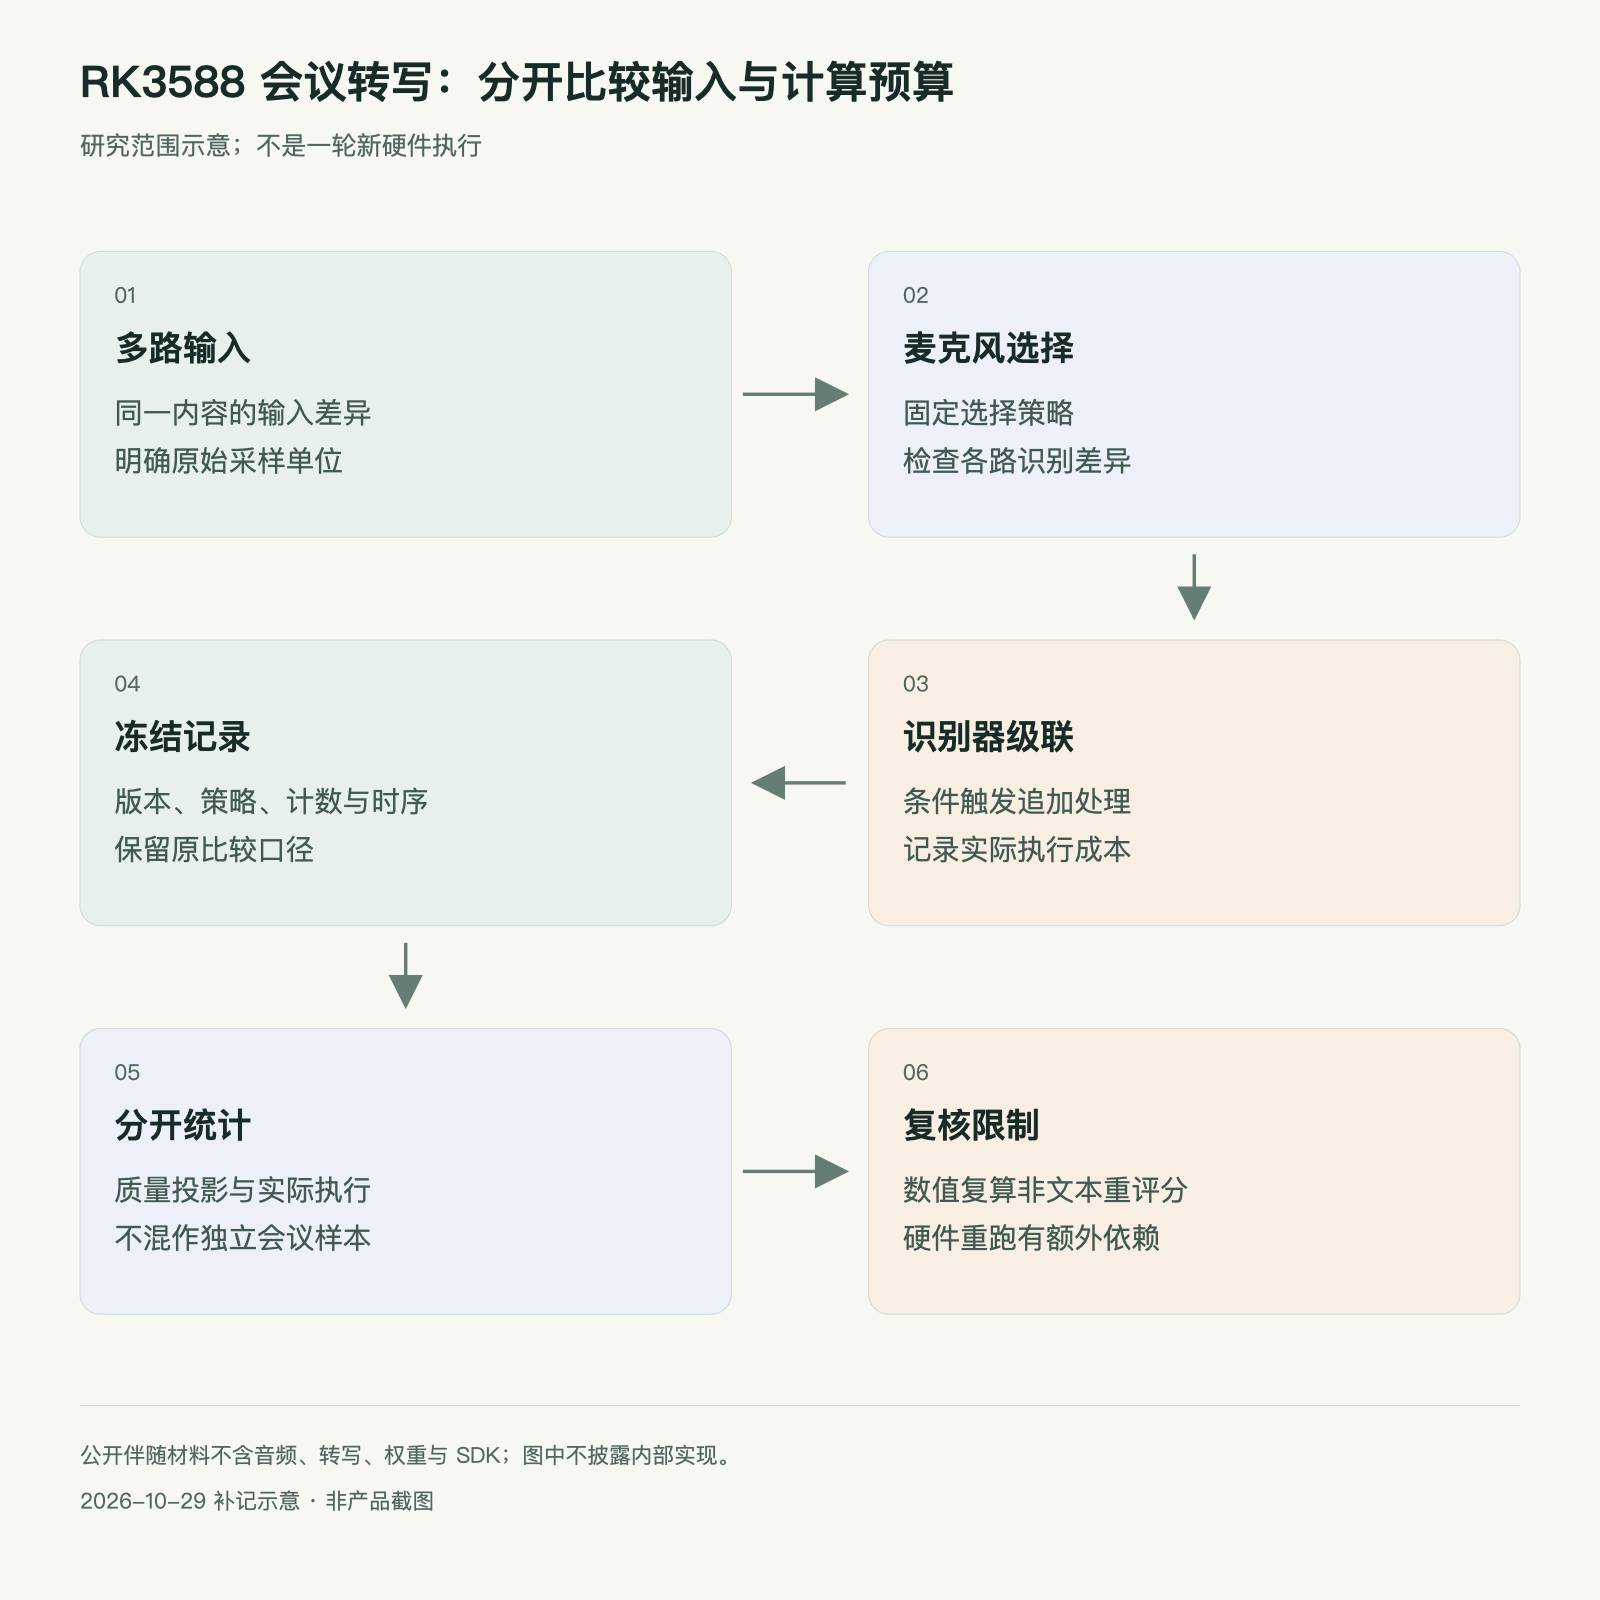
仓库保留了冻结的路由、置信度与 RF 实现,方便查看当时采用的规则。对应入口和依赖范围见硬件实现说明。
2. 质量投影与实际运行成本
| 记录 | 它能回答什么 | 不能混成什么 |
|---|---|---|
| 质量投影 | 根据已有各路识别结果,推算某种选择会得到怎样的质量 | 不是路由策略在设备上重新运行的记录 |
| 实际成本 | 设备执行的耗时、组件成本和对应模式 | 不是新增的独立质量样本 |
| 匹配服务比较 | 同一比较框架中的策略、时间块、模式与轮次差异 | 时间块和系统缓存仍可能混在差异里 |
已有结果库可用于计算不同选择规则下的识别质量,板端运行时间则需要实际测量。公开材料分别保存质量投影行和实际成本行,匹配比较时记录策略、时间块、运行模式与轮次。
重复执行用于观察运行时间的变化;独立会议和参与者数量仍按原始采样单位计算。文件名中的说话人标签未提供独立参与者身份依据,分组和重采样需要按实际采样单位处理。
3. 公开数值的离线复算
3.1 标准库复算入口
仓库根目录下,用 Python 3.9+ 标准库就能检查文件完整性,并重算 A/F/C/EV 几组数值 CER 摘要:
python3 -B reproducibility/reproduce.py命令来自固定提交 README。完整的质量/成本 bootstrap 和绘图还要先准备对应依赖,具体步骤见复算说明。
3.2 合并 CER 与等录音平均
公开输入包含逐样本编辑计数。合并 CER 按总错误数除以总参考字符数,等录音平均则先算每份录音的 CER,再取平均。两者给长短录音的权重不同,所以代码保留两种归一化口径和相关摘要。
复算使用已发布的编辑计数。参考文本与识别文本未公开,复算范围是统计结果,不含原始转写的重新评判。
4. 文件校验与统计限制
配置、逐样本数值、统计代码和文件哈希一起保存。成功运行后会生成 reproduced/VERIFICATION.json,应查看本次状态,再使用生成的输出。绘图脚本可根据这些数值重新生成图表。
匹配模式的运行差异同时受时间块和操作系统缓存影响,插桩开销无法单独分离。部分分层只有一个观察单位,重采样无法估计层内变异。
5. 硬件重跑依赖
板端重跑需要运行时、SDK、模型和原始输入。模型转换链与原始检查点仍有缺失,完整硬件实验目前还无法按仓库直接重建。数据获取条件见数据与访问说明。
音频、转写原文、神经网络权重、SDK 二进制、私有执行日志和维护脚本没有发布。各部分资源的许可与访问条件分别列明,仓库未作统一的开源再许可。
Comments NOTHING